
OpenAI 自曝遞歸自我提升:智能體指數級爆發,人類已成瓶頸
作者:ASI 啟示錄,新智元
OpenAI毫無徵兆地宣布:「遞歸自我提升」(RSI,Recursive Self-Improvement)的齒輪,已經正式開始轉動。
通俗來說,OpenAI親口作證:AI開始研發AI了!
長久以來,人們都在猜測超級人工智能(ASI)會在哪一天降臨。大家盯著大模型的跑分,盯著參數量的飆升。
但OpenAI明確告訴你:通往ASI的真正拐點,根本不是模型跑分超越人類,而是「AI開發AI」閉環的成型。
算力狂歡, 每天燒掉 2.3 萬美金的「超級打工人」
在OpenAI內部,研究員們使用AI智能體的頻率,已經徹底失控------當然,是向上的失控。
以API標價計算,今年9月份在智能體上的花費,中位數研究員是每人每天1500美元。
僅僅過了一個月,到了10月,這個數字飆升到了2400美元,增幅高達62%。
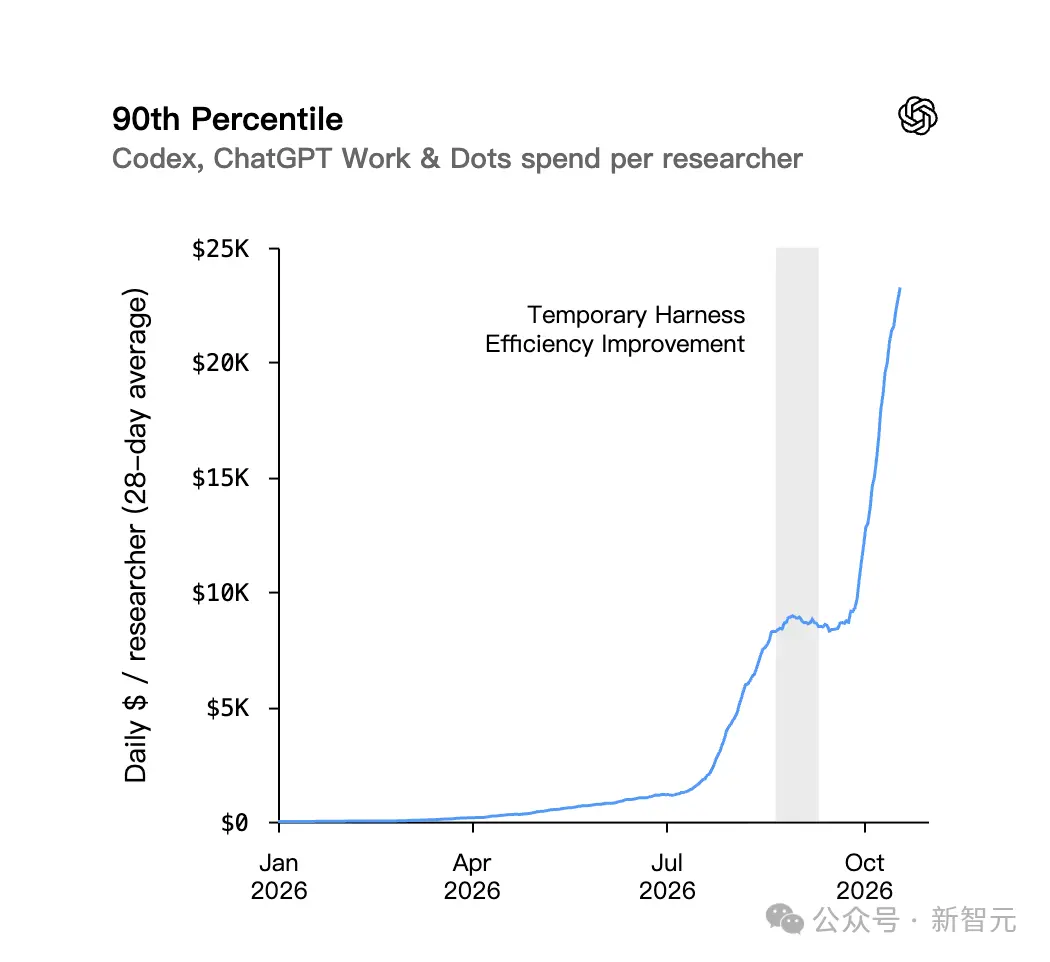
但這只是平均水平。那些排名前10%的「重度用戶」呢?他們每天在智能體上燒掉的額度高達23000美元,環比暴增105%。
一天兩萬多美金。如果你對API的價格有概念,就會知道這背後代表著何等龐大的代碼生成量、邏輯推理推演和並發任務執行。這不是人類在敲鍵盤,這是成百上千個「矽基大腦」在不知疲倦地全速運轉。
為了更直觀地衡量,OpenAI引入了一個概念:「智能體工作日」(每8小時的智能體使用算作一個工作日)。
數據顯示,每位研究員每天平均的「智能體工作日」,已經從最初的0.5個,恐怖地飆升到了5.7個,足足增長了11倍!
在最核心的預訓練和後訓練團隊,這個數字更是達到了8個。
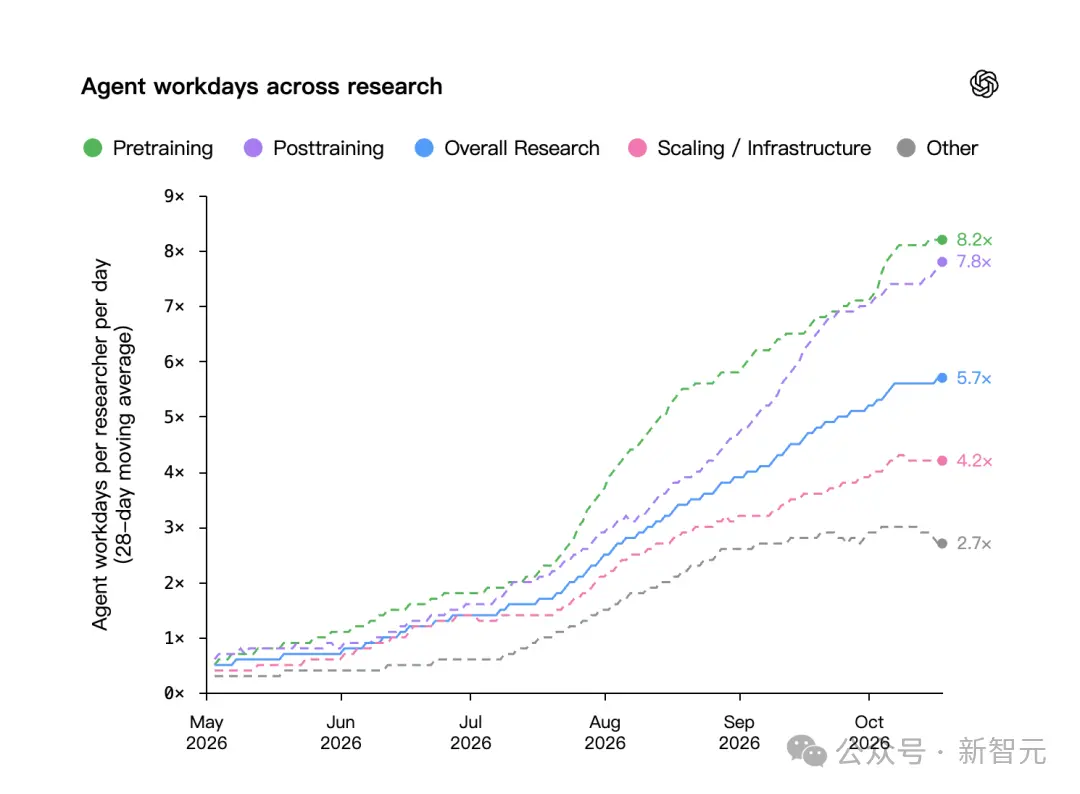
這意味著一個人類研究員每天工作8小時,而他的「AI分身們」在同一時間裡,並發完成了相當於64個小時的工作量。
到了10月中旬,超過十分之一的研究員,每天手頭都有至少16個智能體在同時處理任務。
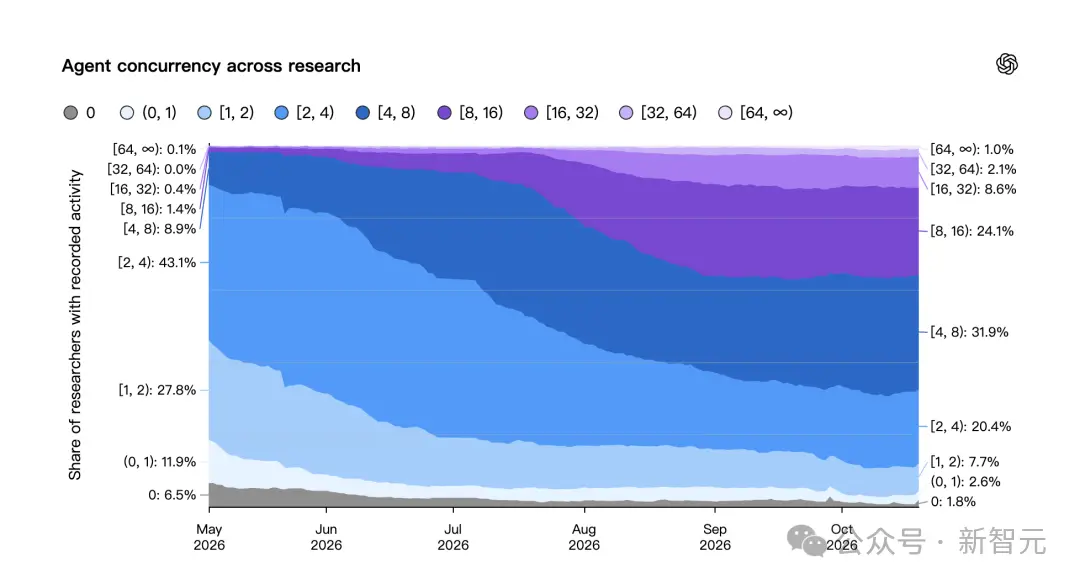
人類工程師對這些AI工具的依賴,已經到了近乎「成癮」的地步。
在OpenAI內部進行的一項匿名調查中,研究員們被問到一個極其尖銳的問題:「如果未來3個月內,沒收你們所有優於GPT-5.2的編碼智能體,你願意拿什麼條件來換回它們?」
中位數的回答讓人震撼:他們寧願裁掉團隊40%的人手,或者削減當前團隊30%的核心算力。
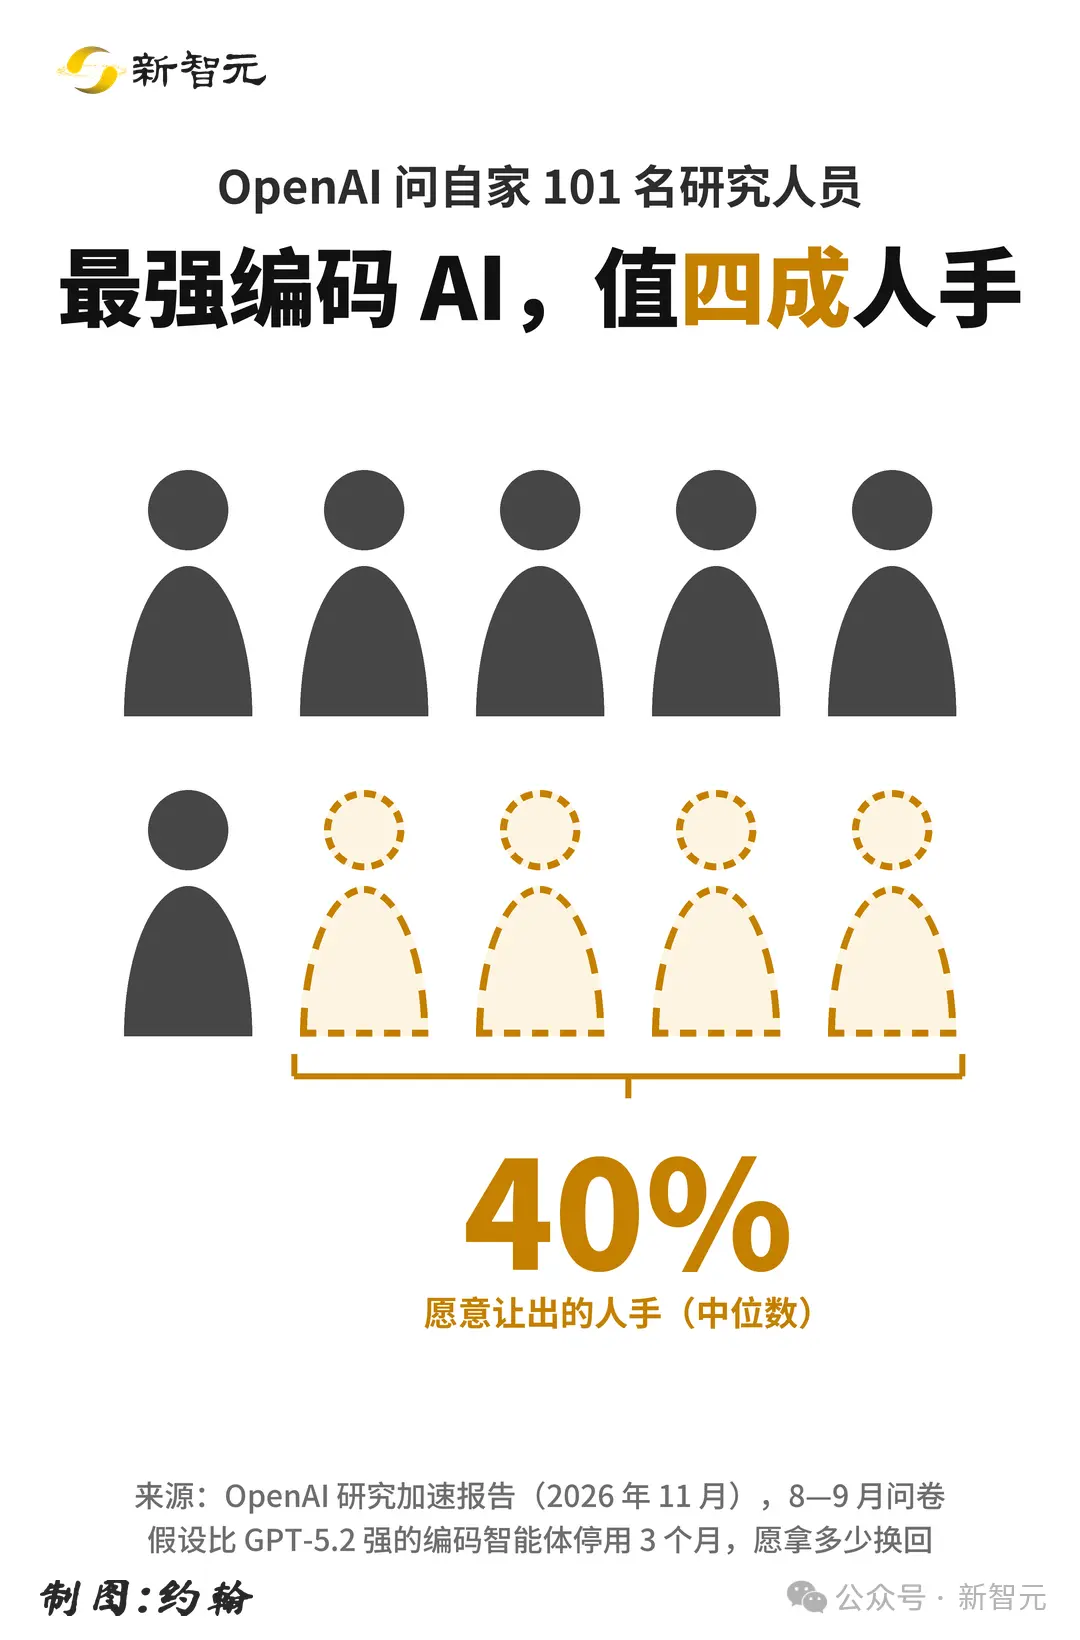
在最頂尖的AI研究員眼裡,幾台昂貴的H100算力集群,甚至身邊活生生的同事,都已經比不上一个前沿編碼智能體的價值。
真正讓人後背發涼的細節:AI 開始擁有「科研品味」
真正讓矽谷大佬們驚呼「瘋狂」的,是GPT-6.2 Astra的研發內幕。
在過去,大想法(Big Ideas)總是人類的專屬領地。
在開發較早版本的GPT-6 Astra時,OpenAI的研究員們依然驕傲地表示:核心的科研想法完全是人類構思出來的,模型只是個高級碼農,負責把想法變成代碼。
但到了GPT-6.2 Astra,情況發生了微妙但致命的變化。
在訪談中,預訓練團隊的研究員承認,核心洞見是在與模型(Codex)的反復對話中誕生的。
一位研究員明確表示,Codex在他們共同推進一個想法時,精準地識別出了關鍵洞見。
另一位核心人員則坦言,自己一開始的想法走進了死胡同,「只有在Codex建議做出改變後,整個想法才真正開始奏效。」
AI開始擁有直覺,開始識別出人類忽略的盲點,甚至開始指導人類如何造出更好的AI。
這被稱為**「科研品味」(Research Taste)**。
發現問題往往比解決問題更難。當AI具備了鑑別「什麼樣的數據更好」、「什麼樣的架構更有前途」的品味時,潘多拉的魔盒就真正打開了。
有開發者發推描繪了這個反饋循環(Feedback Loop):
- 一位研究人員想讓AI模型在邏輯推理上更強。
- 他們召喚出幾十個智能體去編寫底層代碼、配置環境、運行海量實驗,並測試出到底哪幾行改動真正有效。
- 那些被智能體證明成功的改動,被打包塞進下一個版本的模型中。
- 下一個版本的模型因此變得更聰明,於是它能幫助研究人員去解決上個版本根本看不懂的、更難的代碼Bug。
循環往復,永不停息。
每一個更好的AI,都在以前所未有的速度,幫助人類構建下一個更強的AI。這就是真正的「遞歸自我提升」(RSI)。
一旦這個飛輪的轉速突破某個臨界點,AI的發展速度將徹底脫離人類習慣的線性認知,呈現出近乎垂直的指數級爆炸。
崎嶇的前沿:「閉環」已成,但人類依然是瓶頸
當然,如果現在就宣布AI已經完全自主,未免過於聳人聽聞。
OpenAI坦承,當前的技術依然存在巨大的局限性。他們將目前的階段稱為**「崎嶇的前沿」**(Jagged Frontier)。
什麼是崎嶇?就是極度的偏科。
從今年3月到10月,對於那些估計需要2到4小時才能完成的複雜研發任務,智能體的「零干預成功率」(即人類完全不插手)從23%翻倍躍升至46%。哪怕是難度更高、需要4到8小時的長線任務,成功率也從13%漲到了35%。
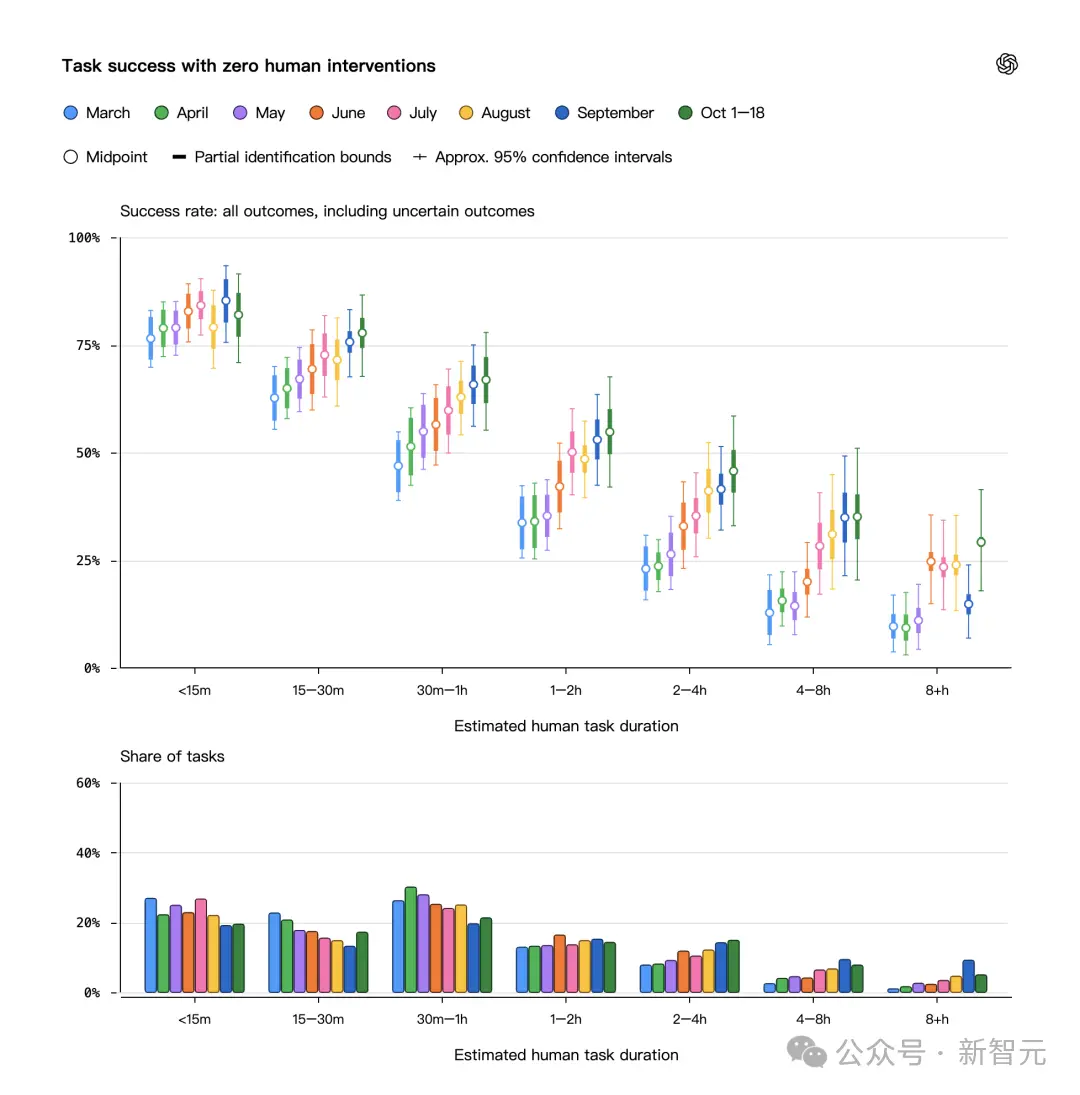
但如果把任務拆細,你會發現AI的能力邊界非常參差不齊。監控訓練運行問題成功率79%。但編寫底層推理和服務棧代碼,成功率僅25%。
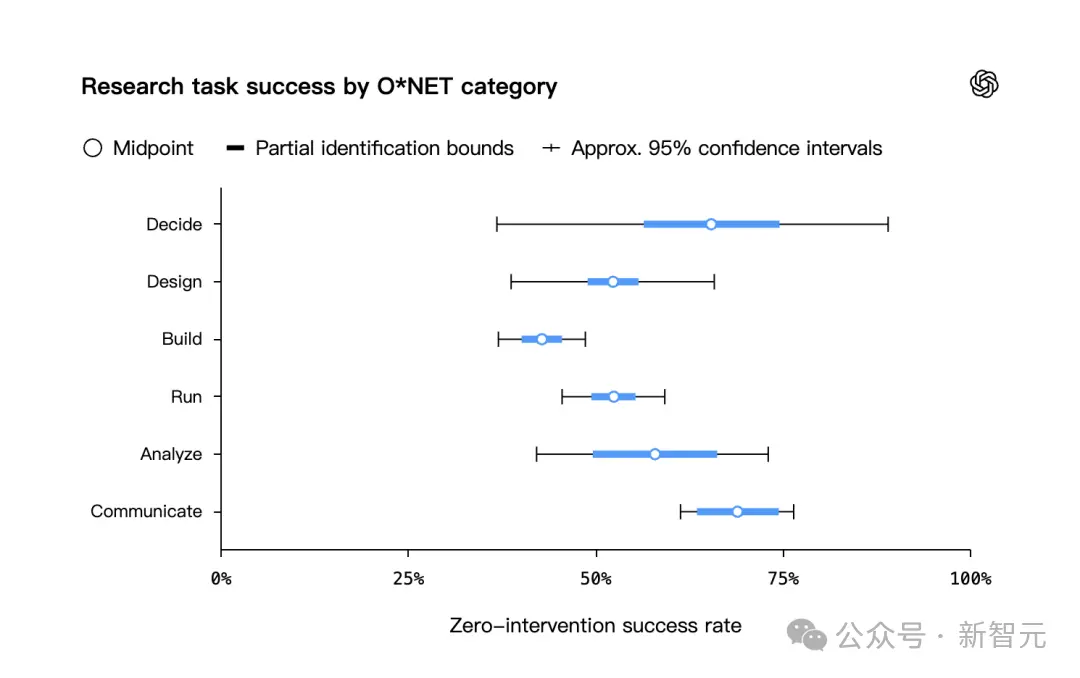
數據表明,當任務涉及到高度抽象的「從零構建」時,AI的成功率就會驟降。
它在溝通(69%)和分析(58%)上極其出色,但在開發(43%)上依然像個莽撞的學徒。
在內部訪談中,人類研究員對AI的吐槽依然密集。
為了修復一個小Bug去重構整個模塊,AI會鑽牛角尖;它會寫出看似華麗實則跑不通的「AI垃圾」PR(拉取請求);它會產出不可用的數據,甚至做出極其荒謬的分析假設。
一位從事後訓練評估的研究員無奈地總結了他的新工作流:
「我以前試過直接對AI說『你就把這個任務做成那個任務那樣』,結果被坑了太多次,因為它總會理解偏差,我還得去給它擦屁股。
現在的策略變了,我說:『你先做一個,我來審、我來改。等我確認對了,你再去做剩下的一萬個。』」
你看,這就是當下的現實。人類依然是AI研發閉環中的絕對核心,只不過,人類的角色從「創作者」變成了「審核員」。
人類提供最初始的判斷力和容錯底線,而AI負責將這個底線放大一萬倍。
但這種平衡極其脆弱。就像一位研究員在報告中留下的那句意味深長的話:「我確實認為,我現在在科研想法上比AI更有品味。但我完全沒有信心,這種情況還能在多長的時間內繼續成立。」
終局已定?OpenAI 的緊急呼籲與新秩序
在報告最後,OpenAI罕見地發出了一項極具壓迫感的行業呼籲:強制公開RSI指標。
他們認為,所有頂尖的AI實驗室,都應當被要求追蹤並公開報告「遞歸自我提升」的核心指標。公眾和監管機構有權知道,AI加速未來AI系統開發的過程,究竟走到了哪一步。
為什麼要公開?因為進步的速度已經超出了傳統直覺的感知。
報告中披露,旨在衡量通用AI能力進步趨勢的OpenAI ECI(內部能力指數)顯示,自2025年8月以來,OpenAI模型的ECI前沿正在以每年16.4點的速度狂飆,超過了行業平均的14點。
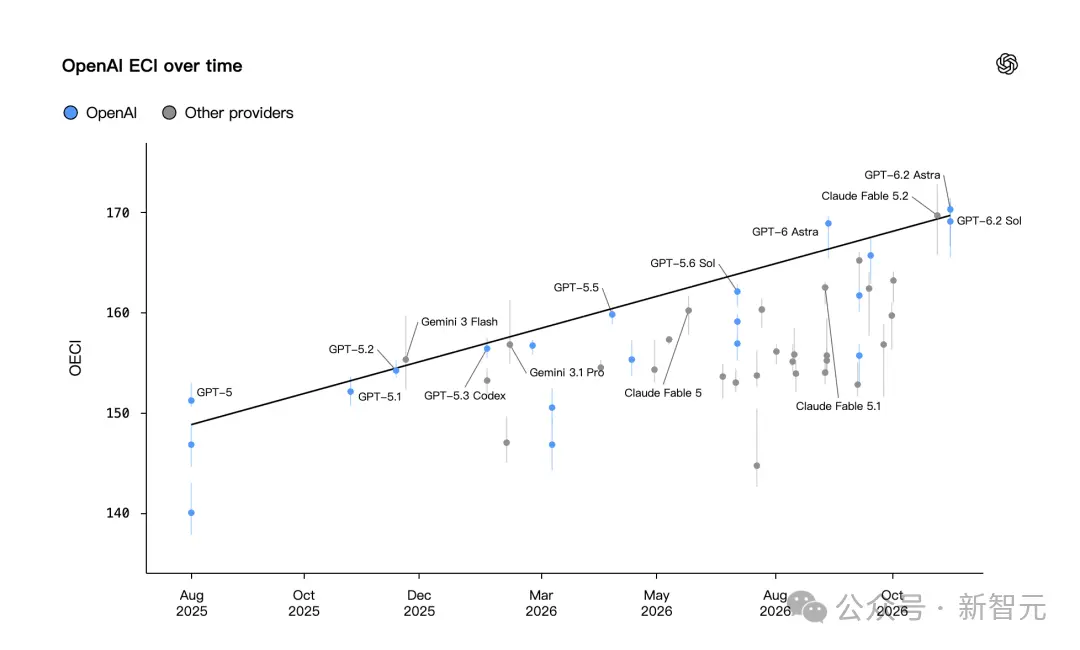
更可怕的是,如此驚人的進步,僅僅動用了OpenAI總研發算力的2%來部署內部智能體。
想像一下,當這個比例達到20%、50%甚至80%的時候,會發生什麼?
傳統的「人類研發週期」正在被打破。以前,迭代一個模型需要半年收集數據、三個月訓練、兩個月微調。現在,智能體正在用並發的算力,在幾小時內完成人類幾週的工作量。
正如報告中所警告的:歷史趨勢可能已經無法預測未來。
在數學領域,前沿模型近期已經展現出了突然而快速的突破,AI領域的「突變」隨時可能降臨。