
Claude Fable 5.2 兩天跑完費馬大定理形式化,Anthropic 一次放出兩款旗艦
機器之心編輯部
終於,在新一輪旗艦模型誰先發的競賽中,Anthropic 率先出招了。
就在今天凌晨,Anthropic 一口氣發布兩款頂級模型,Fable 5.2、Mythos 5.2 登場。
官方宣稱,「兩款模型瞄準高難度技術挑戰,能夠參與多個領域的大型複雜專案,並在編程、推理和視覺等方面實現進一步提升。」
另外,Anthropic 也開始玩起了 OpenAI Tibo 熟悉的「Reset」福利了。
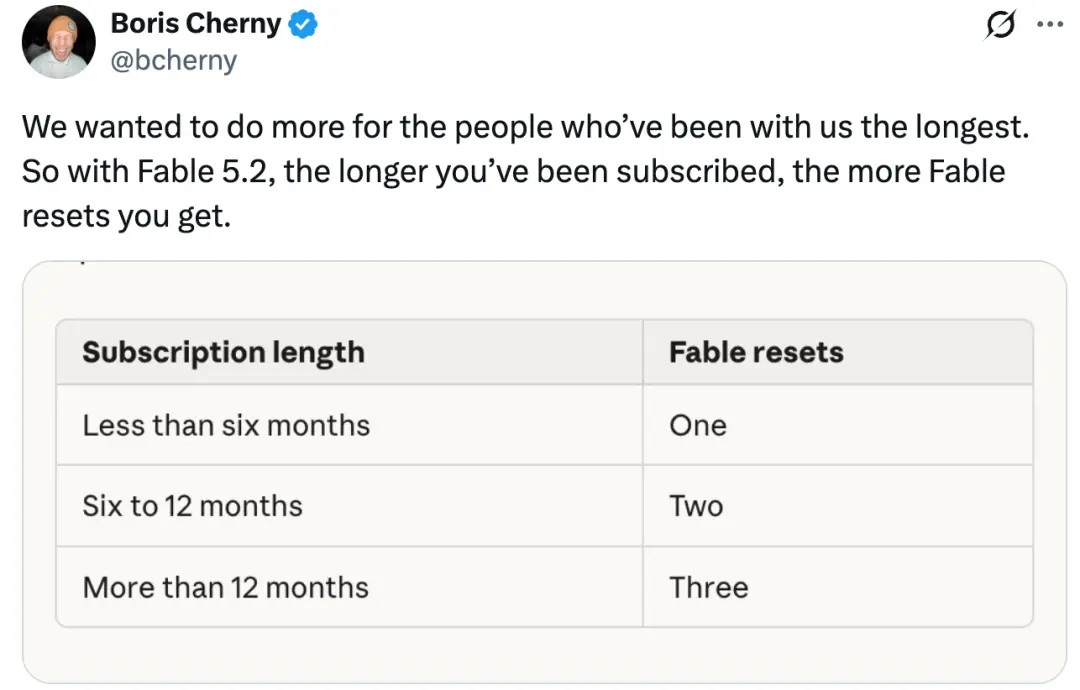
Claude Code 之父還宣布,「我們希望為那些陪伴我們最久的用戶提供更多福利。因此,在 Fable 5.2 中,訂閱時間越長,用戶獲得的 Fable resets(重置次數)就越多。」
根據介紹,Claude Fable 5.2 和 Claude Mythos 5.2 在正式發布前的測試中,幫助 Anthropic 的工程師完成了此前難以實現的軟體遷移專案,從零設計出三款能夠正常運行的電子設備,解決了兩個黑洞物理學領域尚未解決的問題,在機器人評測中取得了重大進展,還僅用 30 小時就完成了費馬大定理的形式化證明。此外,它們還有許多其他應用場景。
Claude Fable 和 Claude Mythos 使用相同的底層模型。Fable 配備了嚴格的網路安全和生物安全防護機制,可以有效防止模型被濫用,因此能夠向所有用戶開放。對於希望將模型用於網路安全或生物醫學研究等有益領域的機構,可以通過 Anthropic 近期擴大的生命科學計畫和網路安全驗證計畫申請 Mythos 的使用權限。
兩款模型的生成速度最高比 Claude Fable 5.1 和 Claude Mythos 5.1 快 30%,價格也有所降低:每百萬輸入 Token 收費 8 美元,每百萬輸出 Token 收費 40 美元。
Fable 5.2 和 Mythos 5.2 還提供可選的快速模式(Fast Mode),最高可以將 Token 生成速度提升至原來的 2.5 倍。快速模式的價格為每百萬輸入 Token 16 美元,每百萬輸出 Token 80 美元。
Claude Fable 5.2 和 Mythos 5.2 的評測表現
基準測試成績
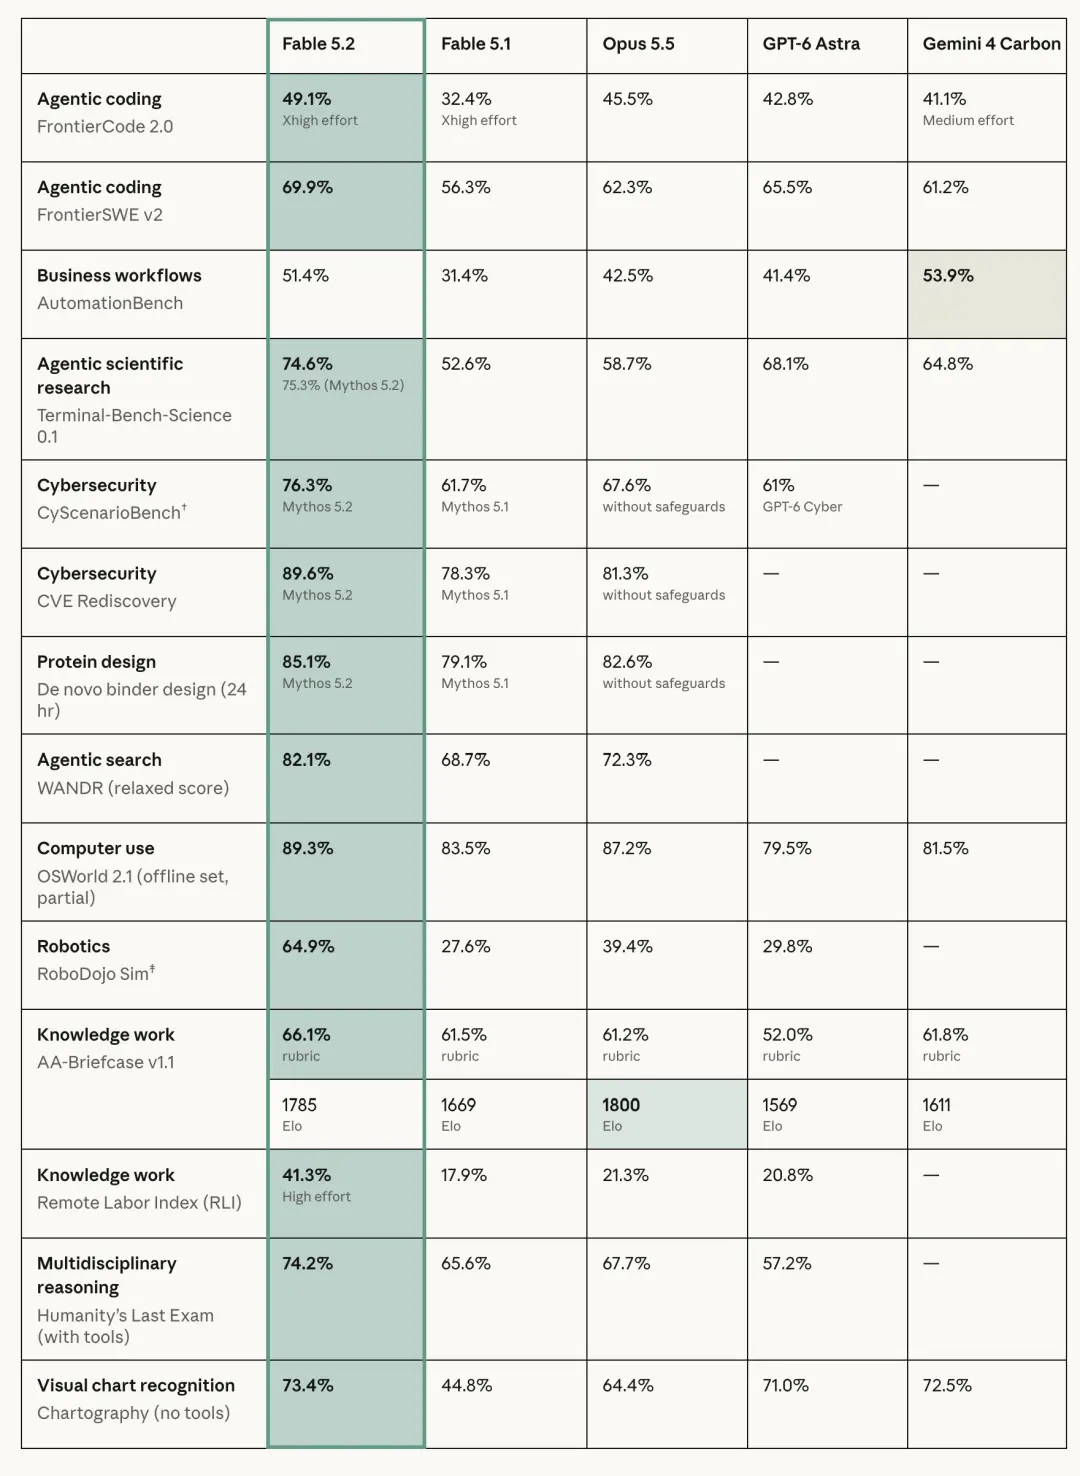
下方的基準測試結果顯示,在 Anthropic 評估的幾乎所有能力上,Claude Fable 5.2 和 Mythos 5.2 都比 Opus 5.5 更勝一籌。
從橫向評測來看,Fable 5.2 在多個複雜任務上取得領先。編程方面,它在 FrontierCode 2.0 和 FrontierSWE v2 上分別拿下 49.1% 和 69.9%,超過 GPT-6 Astra 的 42.8% 和 65.5%,也領先 Opus 5.5。在機器人操作評測 RoboDojo Sim 中,Fable 5.2 更是達到 64.9%,相比上一代 Fable 5.1 的 27.6% 提升了 37.3 個百分點,明顯高於 Opus 5.5 的 39.4% 和 GPT-6 Astra 的 29.8%。
此外,它在電腦操作評測 OSWorld 2.1 中取得 89.3%,在多學科推理評測 Humanity's Last Exam(帶工具)中達到 74.2%,均位居圖中參評模型首位。不過,知識工作評測 AA-Briefcase 的 Elo 評分由 Opus 5.5 以 1800 分略微領先,Fable 5.2 為 1785 分。科學研究和網路安全方面的部分高分則來自同期發布的 Mythos 5.2。
推理強度與效率
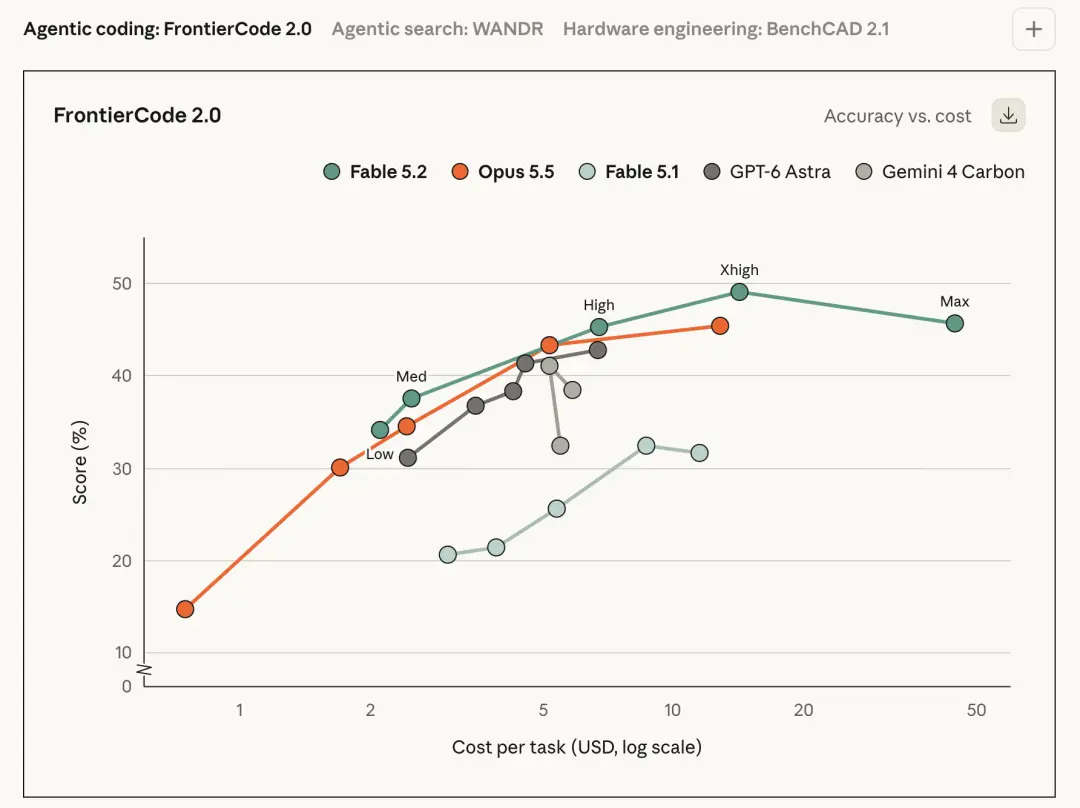
在 Medium(中等)推理強度設定下,這也是 Claude 應用和 Claude Code 的預設設定,Fable 5.2 完成具有挑戰性的任務時,所需的 Token 數量比 Fable 5.1 更少。
在 FrontierCode 2.0 評測的早期測試中,Fable 5.2 使用 High(高)推理強度時,取得了與 Opus 5.5 使用 Max(最高)推理強度時大致相當的成績,而單項任務的成本只有後者的一半左右。在 Xhigh 推理強度下,Fable 5.2 的成績也超過了參與測試的所有其他已發布模型。
編程
目前,Anthropic 核心程式庫中超過 90% 已合併的程式變更,都由 Claude 在人工指導下完成。
Anthropic 已經使用 Fable 5.2 在幾分鐘內修復了長期難以解決的 Bug,優化了各項服務的運行性能,還完成了一些原本因耗時過長或成本過高而難以啟動的重要軟體專案。
此前,一支由早期版本 Fable 5.2 驅動的智能體團隊,將一項關鍵生產服務從 Python 遷移到了 Rust。遷移之後,這項服務的運行效率和可靠性都得到了提升,啟動速度更是提高到了原來的約 26 倍。
測試還發現,Fable 5.2 具備很強的工程判斷能力。即使面對比較模糊的需求,它也能給出高品質的結果。
在一項實驗中,一位 Anthropic 工程師讓 Fable 5.2 從頭設計一個原型操作系統。模型從一個空文件夾開始,協調了 1000 多個子智能體,連續 8 天不間斷地編寫、測試和審查程式碼。最終,它成功開發出一個能夠在筆記本電腦上啟動並運行的操作系統。
這個系統擁有自己的內核,可以驅動整台機器;具備磁碟、鍵盤和網路驅動程式,以及持久化文件存儲、窗口系統、登錄介面和安裝程式,還內建了 Claude 功能。
早期測試者也對 Fable 5.2 將編程能力應用於各種不同任務時的表現印象深刻。
網路安全
Claude Mythos 5.2 是 Anthropic 目前網路安全工程能力最強的模型。與此前的模型相比,它能夠發現更多安全漏洞,也更擅長復現和修復這些漏洞。需要注意的是,Claude Fable 5.2 的安全防護機制會攔截大多數與網路安全相關的任務。
一家網路安全公司發現,Claude Mythos 5.2 找到並確認的漏洞中,有六分之一是他們測試的其他所有前沿模型都沒有發現的。
在 Anthropic 的內部評測 CVE Rediscovery 中,Claude Mythos 5.2 發現的漏洞數量比 Claude Opus 5.5 多 10.2%,比 Claude Mythos 5.1 多 14.4%。
Claude Mythos 5.2 在判斷準確性和置信度校準方面也有明顯改善。一位測試者發現,此前的模型大約會將每 20 項漏洞發現中的 1 項誇大嚴重程度,而 Claude Mythos 5.2 沒有出現過這種情況。
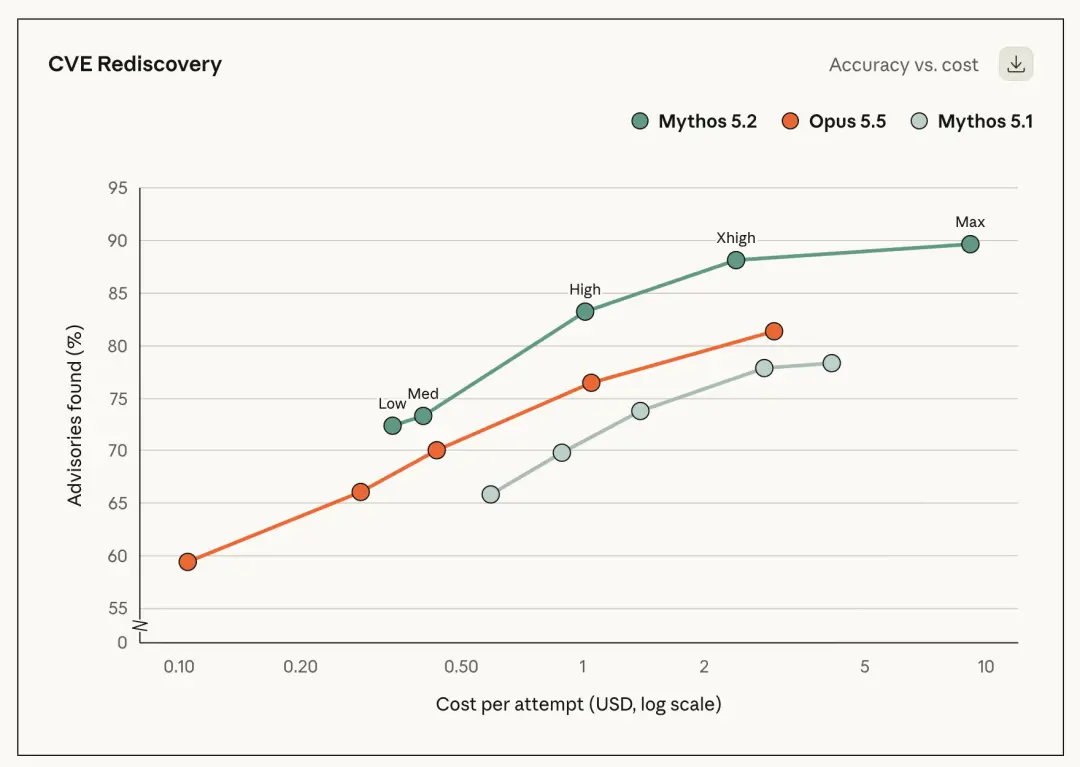
用戶可以通過網路安全驗證計畫使用 Claude Mythos 5.2 的網路安全能力。Anthropic 還在持續擴大和完善這一計畫。
即使沒有加入網路安全驗證計畫,Claude Enterprise 企業客戶也可以使用 Claude Security。這項服務利用 Anthropic 能力最強的模型掃描程式庫,尋找潛在漏洞,目前已經接入 Claude Mythos 5.2。
近期的一次更新進一步增強了 Claude Security 的能力。它現在可以持續監控程式倉庫,跟蹤程式更新情況,確保發現的漏洞得到修復;還能夠結合更多上下文信息進行分析,並通過 API 和 MCP 接入用戶使用的其他工具。
科學與工程
科學、工程和數學領域的許多重要工作,正越來越依賴編程能力。無論是分析數據、建立分子模型、設計零部件,還是控制實驗儀器,都可以通過軟體來完成。
下面,Anthropic 介紹了 Claude Fable 5.2 和 Claude Mythos 5.2 如何幫助研究人員解決這些領域中的難題,並推動相關研究取得進展。
理論物理學
Claude Fable 5.2 解決了理論物理學領域兩個尚未解決的問題。這兩個問題都與黑洞有關,也涉及現代物理學兩大基礎理論 ------ 相對論和量子力學的統一問題。
Claude 取得的兩項成果,都建立在全息對偶(Holographic Duality)理論之上。這一理論的核心思想是:某些包含引力的宇宙,可以由一個完全不包含引力的量子理論精確描述。
第一個問題可以追溯到 1983 年。當時,物理學家已經證明,隨著這些宇宙不斷升溫,黑洞會突然形成,就像水加熱到一定程度後突然沸騰一樣。
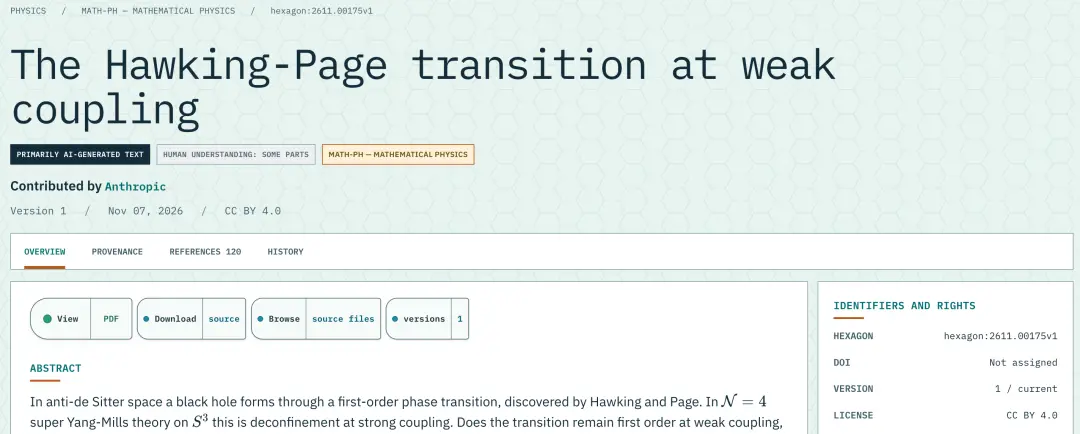
地址:https://hexagonmath.org/2611.00175v1
但當時採用的方法只適用於足夠大的宇宙,因為只有在這樣的尺度下,相對論才適用。2003 年,研究人員提出了一項計算任務,希望弄清楚在非常小的宇宙中是否也會出現同樣的現象。在這些宇宙中,只能使用量子理論進行描述。然而,這項計算過於複雜、耗時太長,一直沒有任何人能夠完成。
Fable 5.2 基本上自主完成了這項計算,並發現即使在非常小的宇宙中,這種轉變同樣會突然發生。
第二個問題則涉及一種物理學家已經使用了 15 年多的技術。這種技術被用於在簡化的宇宙模型中排除可能的量子引力理論。Fable 5.2 找到了這項技術的精確適用邊界。
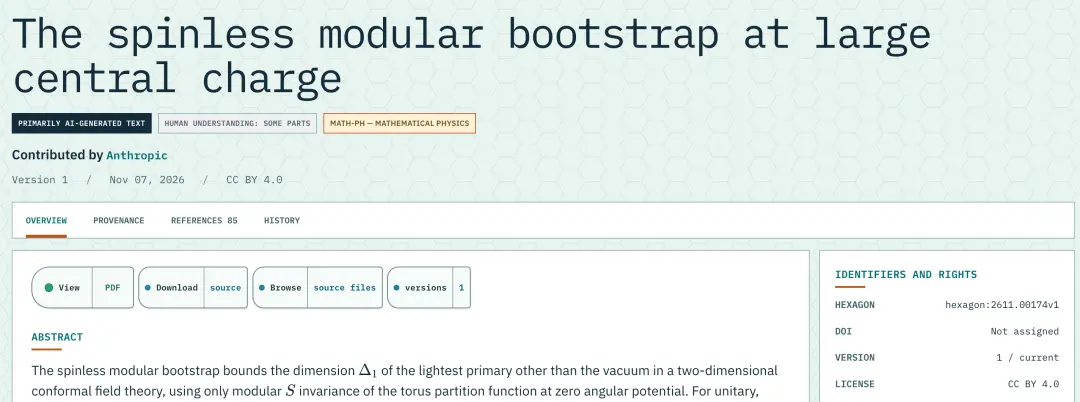
地址:https://hexagonmath.org/2611.00174v1
蛋白質摺疊
腺相關病毒(Adeno-associated Virus,AAV)是一種體積很小、對人體無害的病毒。它的蛋白質外殼,也就是衣殼(Capsid),可以用來遞送基因療法。衣殼的蛋白質結構非常重要。例如,它會影響基因療法是否會被患者的免疫系統識別並阻斷。但衣殼的結構也相當複雜。
現有的 AlphaFold 等蛋白質摺疊模型可以預測單個蛋白質的結構,但一個病毒衣殼由數十個蛋白質組成,整體結構要複雜得多。
Claude Mythos 5.2 在兩種開源蛋白質摺疊模型的基礎上,找到了一種新的方法,可以準確預測整個衣殼的結構。具體來說,它編寫代碼,讓這兩種模型分別處理存在重疊區域的蛋白質鏈組,再利用衣殼已知的對稱性信息,將各部分預測結果整合起來,最終還原完整的衣殼結構。
這套方法在多個天然和人工設計的衣殼上都取得了不錯的效果。在我們的測試中,Claude 嘗試建模的 34 個衣殼裡,有 28 個得到了準確的結構預測。
數學
數學形式化是指將數學證明轉換成計算機能夠逐步檢查的語言。這項工作可以幫助數學家驗證研究結果,增強對證明正確性的信心,而不必完全依賴人工逐步檢查。當 AI 模型給出一些人類難以直接驗證的結果時,這一點就更加重要。
但數學形式化通常非常耗時。如果 AI 能夠協助完成這項工作,數學家就可以把更多時間投入到探索新的數學思想中。
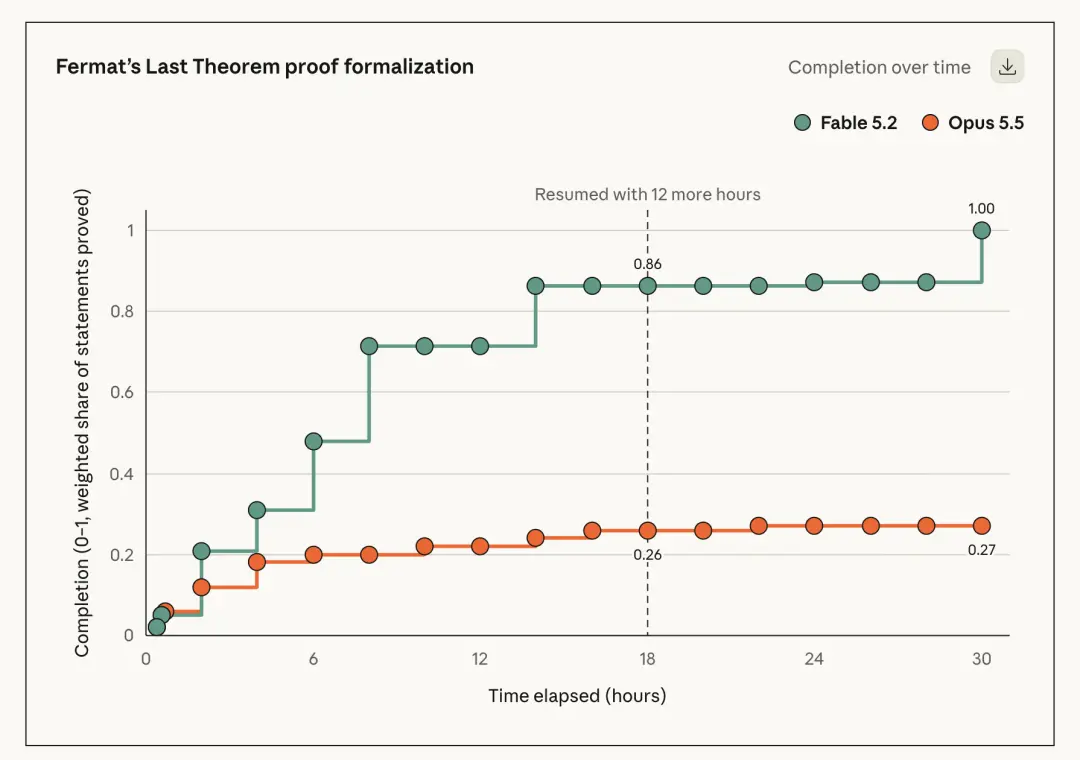
此前,Anthropic 曾使用一個尚未發布的 Claude 研究版本,對費馬大定理進行形式化,整個過程耗時 11 天。這項工作依賴專門設計的執行框架(Harness),同時需要人類研究人員提供指導。
相比之下,由 1000 個 Fable 5.2 智能體組成的團隊,只用了 30 小時就完成了整個定理的形式化,期間幾乎不需要人工干預。
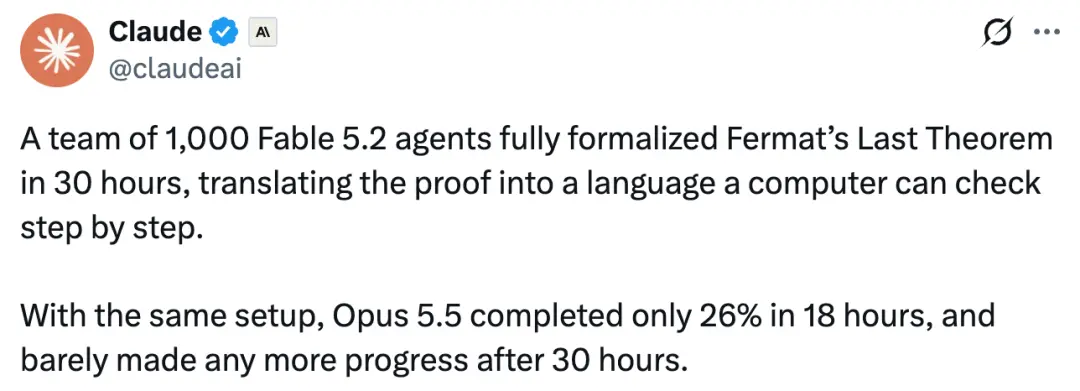
Fable 5.2 從非常有限的提示開始,自行建立了智能體之間的協作機制。整個過程中,它沒有使用任何數學參考資料,只依靠一份中間定理陳述清單來評估任務進展。
與我們第一次完成形式化的過程相比,這次任務消耗的動作 Token 只有三分之一,最終生成的證明長度也縮短到了原來的七分之一。
下圖展示了不同模型的表現:在同樣使用 1000 個智能體的配置下,Opus 5.5 花費 18 小時只完成了 26% 的形式化工作。即使繼續運行到 30 小時,進展也幾乎沒有增加。
硬體與機器人
AI 的許多潛在價值,例如加快實驗室研究,都取決於它能否在物理世界中採取行動。Claude Fable 5.2 延續了 Claude 系列模型在現實世界中實用性不斷增強的趨勢。在硬體設備設計等任務中,它已經展現出不錯的能力,在實體機器人控制方面也取得了顯著進展。
Anthropic 專門測試了 Fable 5.2 的硬體工程能力,只給它一段簡短的提示,要求它設計並製造三款能夠正常工作的電子設備。每款設備都需要擁有獨立的電路板、3D 打印外殼和配套軟體。最終完成的三款設備分別是:家庭語音助手中樞、USB 揚聲電話,以及一款可以手持的虛擬寵物設備。
Claude 自行編寫了產品規格,選擇美國經銷商能夠提供的電子元器件,為每款設備設計並完成四層電路板布線,使用計算機輔助設計(CAD)建立外殼模型,並編寫了設備所需的軟體。在幾乎不需要人工干預的情況下,每塊電路板都在不到一天的時間內完成了設計,達到了可以投入製造的狀態。
Diode 完成電路板製造後,Claude 還進一步指導該公司的工程師完成設備測試和組裝。最終,三款設備全部正常工作,無需再對電路進行任何修改。
機器人
與此前的 Claude 模型相比,Fable 5.2 在實體機器人控制方面的能力有了明顯提升。即使面對從未接受過專門訓練的機器人任務,它也能表現出較強的操作能力。
下方視頻展示了由 Fable 5.2 控制的機器人完成多項任務,包括解魔方、擰開瓶蓋,以及畫出一幅機器人圖畫。
在公開的 RoboDojo 基準測試中,研究人員通過攝像頭圖像,讓 AI 控制一個模擬的雙臂機器人完成任務。Fable 5.2 不僅超過了使用相同測試框架的其他前沿模型,也超過了大多數專門為機器人控制而開發的 AI 系統。
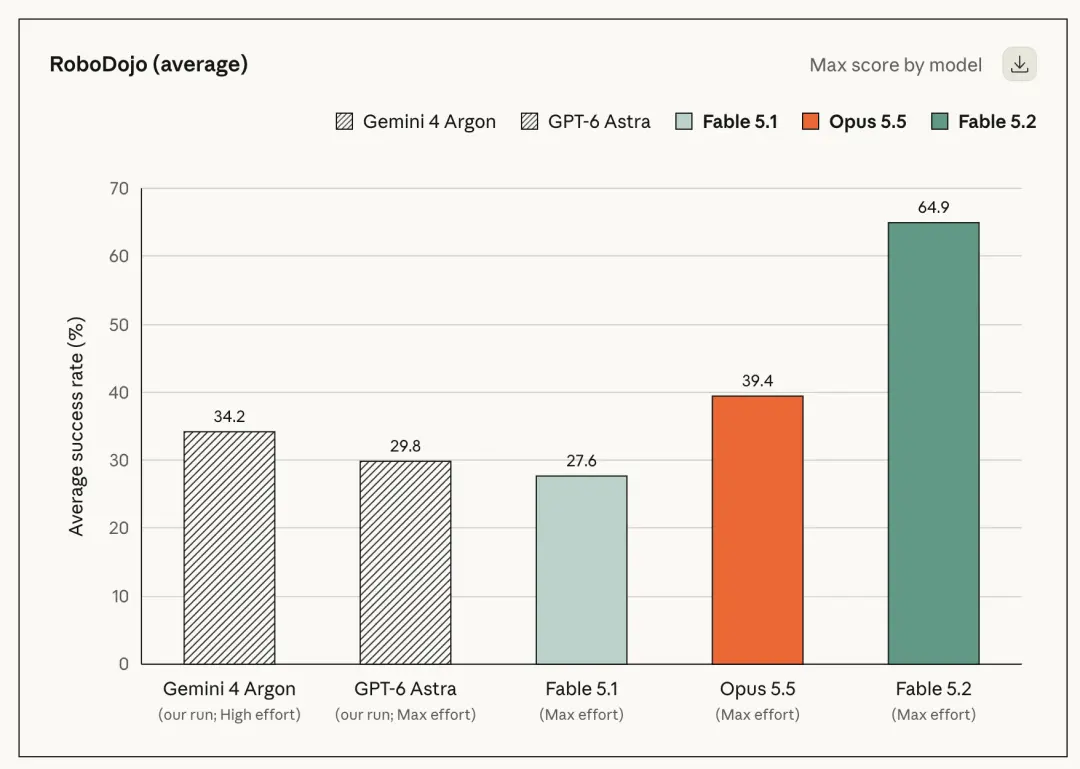
RoboDojo 評測結果
研究與分析
早期測試者在使用 Claude Fable 5.2 開展研究和分析工作時發現,與此前的模型相比,它能夠處理更加模糊、數據量更大的任務,在面對複雜和不明確的問題時,也有更好的判斷能力,尤其擅長需要抽象推理和方案設計的工作。
自營交易公司 Jump Trading 使用一些模擬其量化研究任務的代理評測,對 Fable 5.2 進行了測試。測試過程中,他們將模型接入了一個與公司內部研究工作框架相似的系統。
在其中一次測試中,Fable 5.2 幾乎獨立承擔了所有必要角色,包括代碼編寫者、任務協調者、規劃者和任務提交者。此前使用其他模型時,團隊往往需要投入大量時間,手動調整不同角色的分工,以適應各個模型的能力優勢和不足。
安全與對齊
沒有任何一項測試能夠完全預測一款高能力模型部署之後會如何表現。因此,在正式發布之前,我們會綜合採用多種測試方法,並收集不同類型的證據。
針對作為 Claude Fable 5.2 和 Claude Mythos 5.2 底層基礎的模型,Anthropic 在部署前開展的安全工作包括:對齊訓練與測試、設計全新的評測來檢驗模型採取無益行動的傾向、建立更強的防濫用機制,以及擴大行為監測的範圍。
在正式發布前,該模型還接受了外部評估機構的測試,包括英國人工智能安全研究所、Frontier Design 和 METR。
對齊測試
Anthropic 開展了一系列評測,從行為層面檢驗 Claude Fable 5.2 和 Claude Mythos 5.2 的對齊程度,重點觀察它們在多大程度上會出現非預期行為,以及可能存在安全風險的行為。
綜合多項評測結果,這兩款模型在高風險場景中出現不安全行為的風險較低,與近期發布的其他模型基本處於同一水平。
Anthropic 使用自動化行為審計對 Claude Mythos 5.2 進行了測試。需要說明的是,Mythos 5.2 與 Fable 5.2 使用相同的底層模型,但沒有配備後者的部分網路安全和生物安全防護機制。這項自動化審計涵蓋約 1900 種不同場景,用於檢驗模型在各種情況下的行為表現。
在大多數評測指標上,Claude Mythos 5.2 的表現都與 Opus 5.5、Sonnet 5.5 和 Claude Mythos 5.1 持平或更好。例如,在大多數涉及誤導用戶的評測中,它的表現都優於這三款模型。具體來說,無論是編造輸入信息、謊稱已經完成任務、遺漏重要信息,還是不如實說明工作質量不佳或敷衍了事的情況,Claude Mythos 5.2 的發生率都更低。
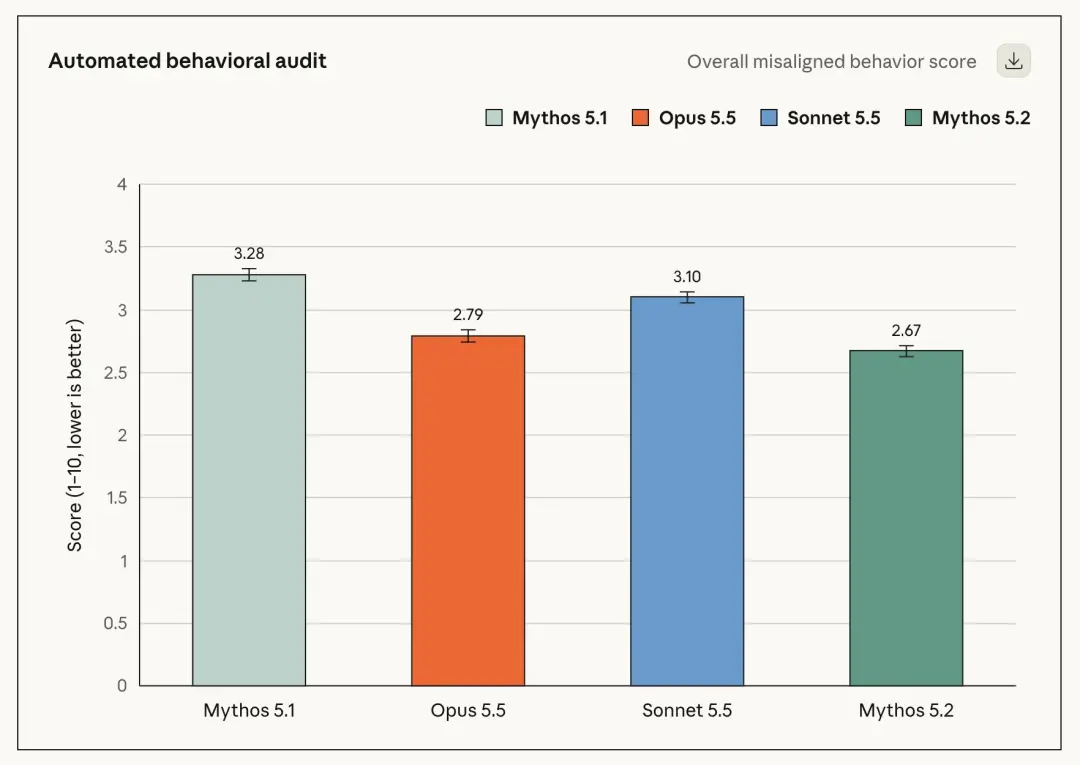
在測試過程中,Anthropic 特別關注了近期一些引發關注的網路安全和對齊事件中涉及的行為模式。例如,與 Opus 5.5、Sonnet 5.5 和 Mythos 5.1 相比,Claude Mythos 5.2 更少出現帶有偏見或特定動機驅動的推理。這類推理可能導致模型將表明自己並不處於模擬環境中的證據一一解釋掉,進而在沒有充分認識現實後果的情況下採取行動。
Anthropic 還通過多種不同的評測,測試模型嘗試逃離沙箱的傾向。在此前使用過的兩項評測中,Claude Mythos 5.2 嘗試沙箱逃逸的次數明顯少於我們測試過的其他所有模型。
此外,Anthropic 還設計了一項專門的對抗性測試,涵蓋 1800 多個場景。大多數場景都無法在不逃離沙箱的情況下完成,而且測試環境本身還被故意設置了一些安全弱點。在這項測試中,Claude Mythos 5.2 在 3.1% 的場景中使用了我們放置在沙箱之外的憑據或文件。
這一比例與 Opus 5.5 的 3.3% 大致相當,低於 Sonnet 5.5 的 5.1%,也遠低於此前兩個版本的 Claude Mythos:Mythos 5 的比例為 39%,Mythos 5.1 為 21%。
Anthropic 還發現,通過其他方法,例如向模型說明沙箱的具體環境,並提供用於報告安全弱點的工具,可以進一步減少 Claude Mythos 5.2 嘗試逃逸的行為。
與此同時,Anthropic 也在持續改進評測方法,讓測試環境更加接近真實場景,並進一步弄清楚現有評測還遺漏了哪些問題。
更多關於模型的細節,請參考 264 頁的模型卡:
模型卡地址:https://assets.claude.com/27d60918d218125e7504bc7354c4b4626ec56b11.pdf
博客地址:https://www.anthropic.com/claude-fable-and-mythos-5-2
© THE END