
OpenAI中端模型開打價格戰,「工具人」GPT-6.1 Terra上線
OpenAI CEO山姆·奧特曼。圖片經由AI處理
文|蘇揚
編輯|徐青陽
OpenAI又推出了一款主打性價比的模型。
美國當地時間10月26日,OpenAI發布中端模型的新版本GPT-6.1 Terra。相比上一代GPT-5.6 Terra,新模型重點提升了視覺理解、計算機操作、事實準確性和編程能力,標準API輸入、輸出價格均下降50%。
在OpenAI自己的測試中,Terra完成計算機操作任務的速度超過GPT-6 Astra和GPT-6.1 Sol的3倍,部分任務的表現已經接近旗艦模型。
這款模型面向日常辦公和高頻自動化任務,能夠識別螢幕內容,在多個應用之間執行操作,也能處理技術圖紙、填寫表單、編輯視頻等工作。
對於開發者來說,它的另一項吸引力是成本:每百萬輸入Token收費1美元,輸出Token收費5美元,緩存輸入Token則只需0.05美元。
不過,速度和價格的優勢並沒有讓所有體驗者滿意。第三方測試顯示,Terra生成視覺作品時,能夠以更低的成本完成複雜場景,但部分用戶仍然認為,它在畫面質感、設計審美和複雜任務處理上存在不足。
01 辦公自動化是主場
GPT-6.1 Terra的重點,是讓AI更快地完成一整套計算機操作任務。
AI助手可以根據用戶要求生成文字、代碼或操作建議,但當任務涉及多個軟體時,模型還需要理解介面、識別控件,再按步驟執行。OpenAI希望Terra進一步降低這類任務的執行成本,讓模型能夠承擔更多重複性的工作。
例如,企業可以讓它讀取收到的發票,將金額、日期和供應商等信息錄入會計軟體;也可以讓它理解建築技術圖紙,或者在桌面應用中完成一連串操作。
OpenAI的官方演示中,GPT-6.1 Terra直接操作Blender,從零開始搭建一輛黃色有軌電車的3D模型,逐步完成車身、車窗、車頂受電弓和底盤細節。
計算機操作基準測試Agents' Last Exam中,在中等推理模式下,GPT-6.1 Terra比GPT-5.6 Terra高出15個百分點,單項任務成本約為後者的三分之一。
與GPT-6 Astra相比,Terra的每Token價格約為其十分之一,任務表現則處於相近水平。
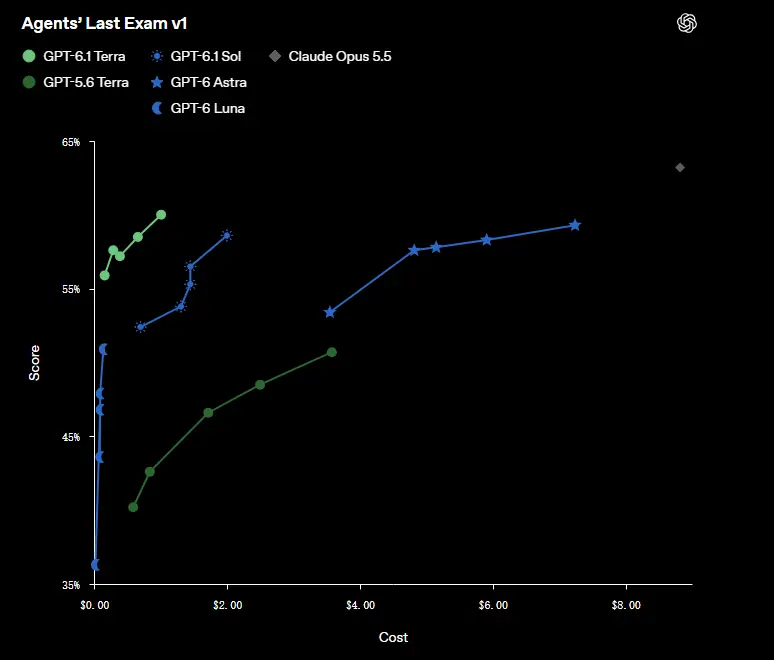
在最高推理模式下,OpenAI稱,Terra的Token使用效率超過Claude Opus 5.5的3倍,每Token價格約為後者的四分之一,最終單項任務成本約低90%。完成任務的速度也超過GPT-6 Astra和GPT-6.1 Sol的3倍。
你可以理解:當任務需要一定推理能力,但又不必動用最強模型時,速度和成本可能成為更重要的選擇依據,而這就是Terra這個檔位模型的"甜蜜點"。
不過,基準測試成績不能直接等同於所有實際工作中的效率。不同任務的步驟數量、工具調用方式和推理強度都會影響耗時,實際使用效果仍要看具體場景。
02 幻覺率下降,編程成績翻倍
除了計算機操作,Terra在事實準確性和編程方面也有明顯提升。
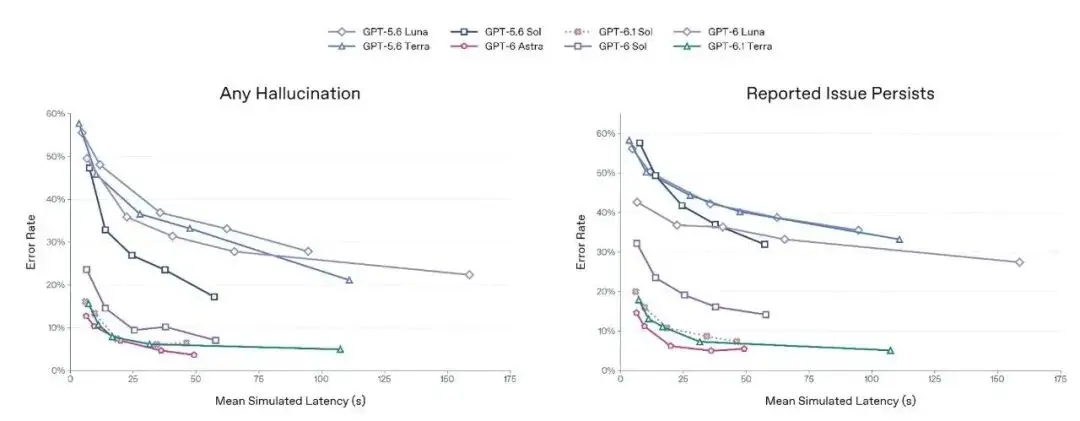
OpenAI使用內部設計的高錯誤誘發提示詞進行測試。在低推理模式下,GPT-5.6 Terra的事實錯誤率為53.6%,GPT-6.1 Terra降至16.7%,下降36.9個百分點。在最高推理模式下,新模型的錯誤率進一步降至4.3%,比前代低18個百分點,接近GPT-6 Astra和GPT-6.1 Sol的水平。
第三方評測機構Artificial Analysis也觀察到了類似變化。其自有的AA-Omniscience知識與幻覺基準測試顯示,當模型不知道問題答案時,GPT-6.1 Terra猜測答案的比例為38%,而GPT-5.6 Terra為88%。與此同時,新模型的準確率提高了2個百分點。
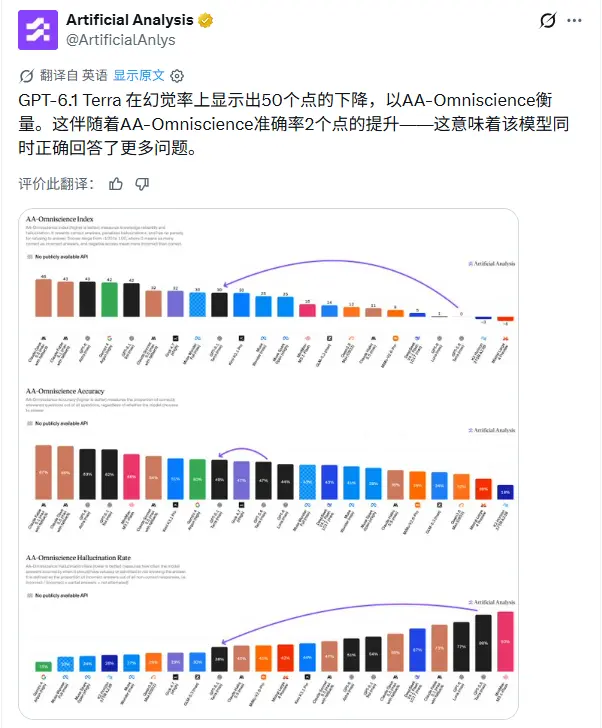
不過,這項結果來自特定測試集,不能直接推導出模型在所有實際場景中的錯誤率。
編程方面,Terra的提升同樣明顯。
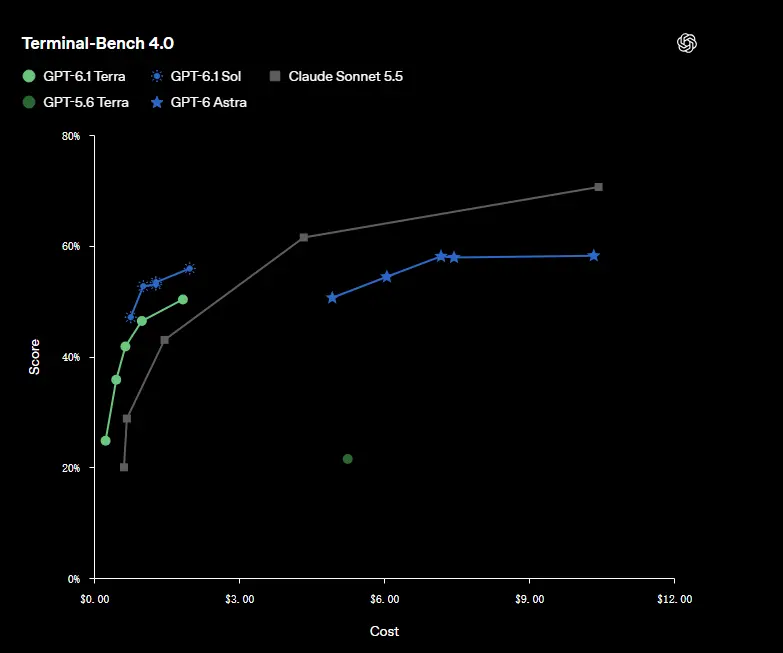
在Terminal-Bench 4.0中,模型需要通過命令行完成軟體工程任務,例如修復網頁加載過程中出現的佈局錯位。在最高推理強度下,GPT-6.1 Terra的任務解決率達到50.3%,超過GPT-5.6 Terra此前公布的21.5%,增幅超過一倍。
Artificial Analysis發布的Coding Agent Index v2.0則給Terra打出48分,低於GPT-6.1 Sol的54分,但高於GPT-6 Luna的31分。該機構認為,Terra在低推理強度和超高推理強度設置下,具備較好的成本效率。
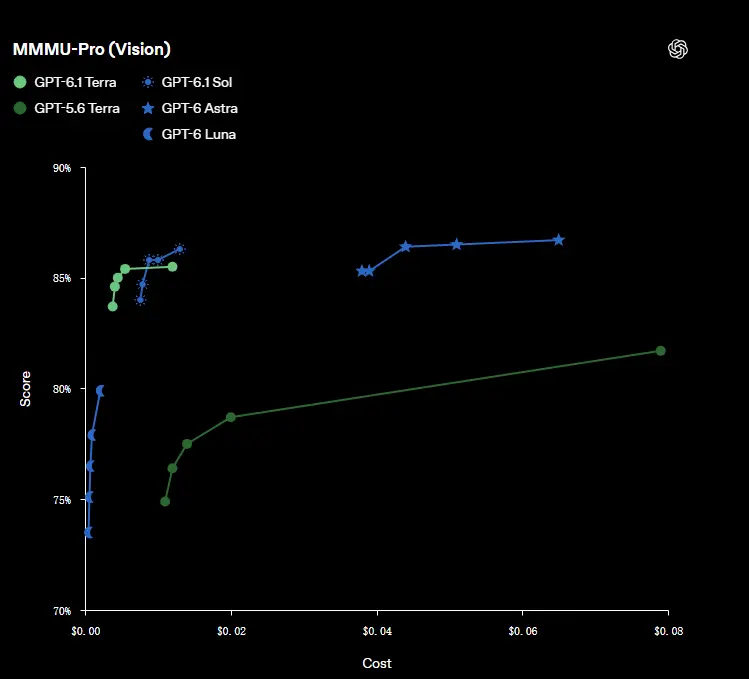
視覺理解測試MMMU-Pro和桌面操作測試OSWorld 2.1也顯示,Terra整體優於GPT-5.6 Terra。對於需要理解圖像、操作軟體並完成多步驟工作的用戶來說,這些能力可以相互配合。
但OpenAI也承認,對於最複雜的編程任務,GPT-6.1 Sol和GPT-6 Astra仍然是更合適的選擇。Terra的優勢主要集中在成本敏感、任務量大、操作流程相對明確的工作中。
03 真實的"買家秀"
從社交平台的反饋來看,開發者對Terra的評價有明顯分歧。
設計評測平台@DesignArena選擇了里斯本的貝倫塔作為測試對象,讓GPT-6.1 Terra和GPT-5.6 Terra在金色時段重現這座16世紀的石灰岩建築,並加入海鷗、帆船和遠處的大橋。
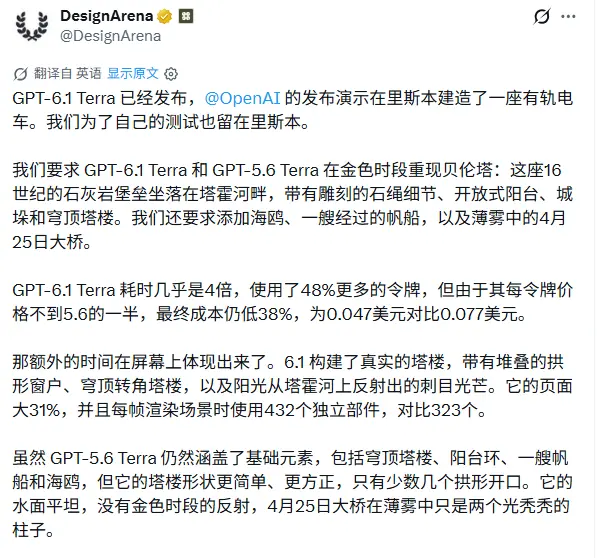
測試結果顯示,GPT-6.1 Terra花費的時間接近前代的4倍,使用的Token也多出48%。但由於單Token價格大幅降低,最終成本反而下降38%,從GPT-5.6 Terra的0.077美元降至0.047美元。
從實際的demo來看,兩款模型生成的畫面也有差異。
DesignArena認為,GPT-6.1 Terra還原出了更複雜的建築結構,包括層疊的拱形窗戶、穹頂轉角塔樓,以及塔霍河面上的陽光反射。生成頁面的尺寸大31%,每幀使用432個獨立部件,高於前代的323個。
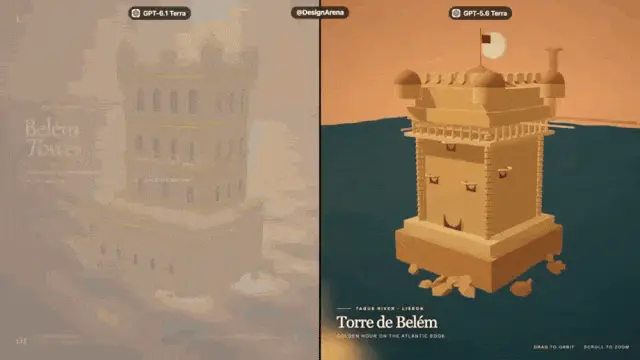
相比之下,GPT-5.6 Terra雖然也生成了穹頂、陽台、帆船和海鷗,但建築形狀更加簡單,水面缺少明顯的光影變化,遠處的大橋也沒有呈現出同樣細緻的結構。
AI模型測試帳號@N1njaCodex對比了GPT-6.1 Terra和Claude Opus 5.5生成像素藝術風格羅馬競技場的表現。
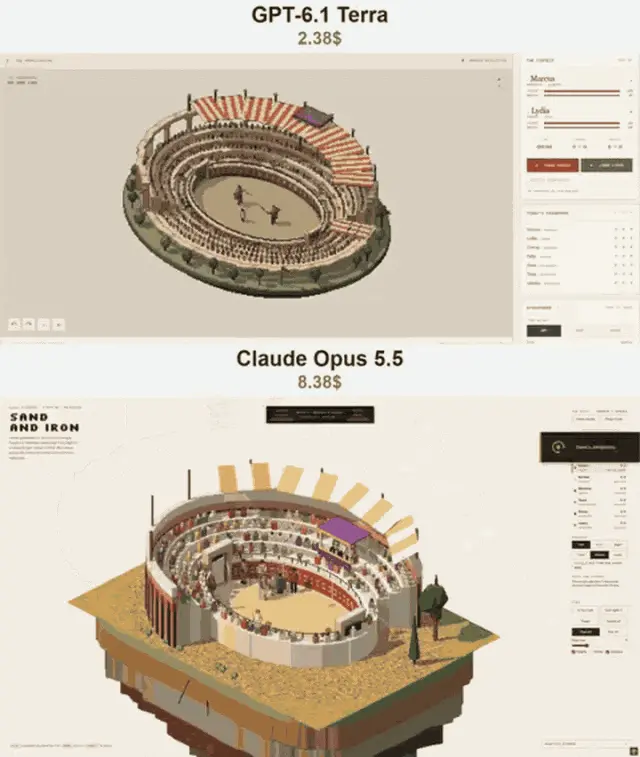
兩款模型完成相同任務的花費分別為2.38美元和8.38美元。NinjaCodex認為,Terra以這樣的價格完成任務已經不錯,但Opus生成的競技場更明亮,畫面層次也更豐富,因此仍然更喜歡後者。
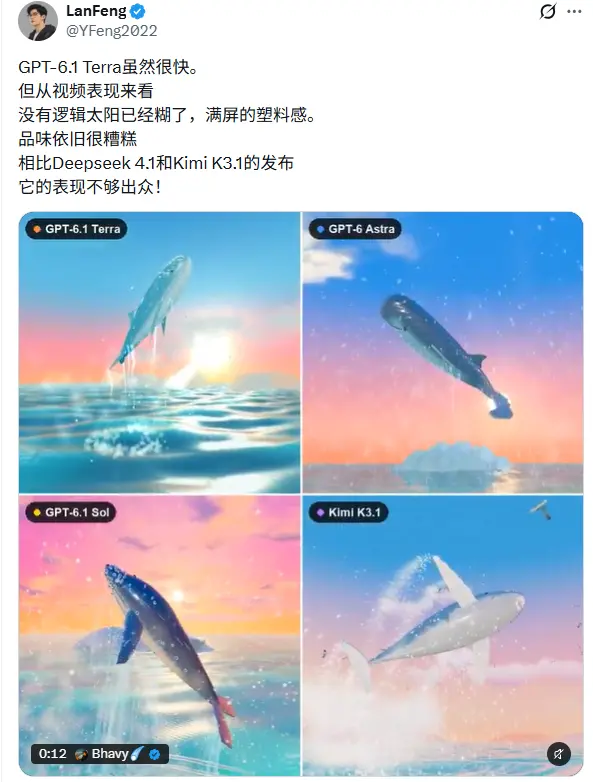
AI獨立開發者@YFeng2022也對Terra的視覺表現提出質疑。他認為,從視頻演示來看,模型生成的畫面存在塑料感,審美表現仍不理想,並認為其整體效果不如DeepSeek和Kimi近期發布的模型。
另一位模型追蹤帳號@Mr_Salio則對Terra的整體表現持負面態度。他認為,模型的速度雖然突出,但綜合體驗未達到預期,甚至認為GPT-5.6在部分測試中的表現更好。
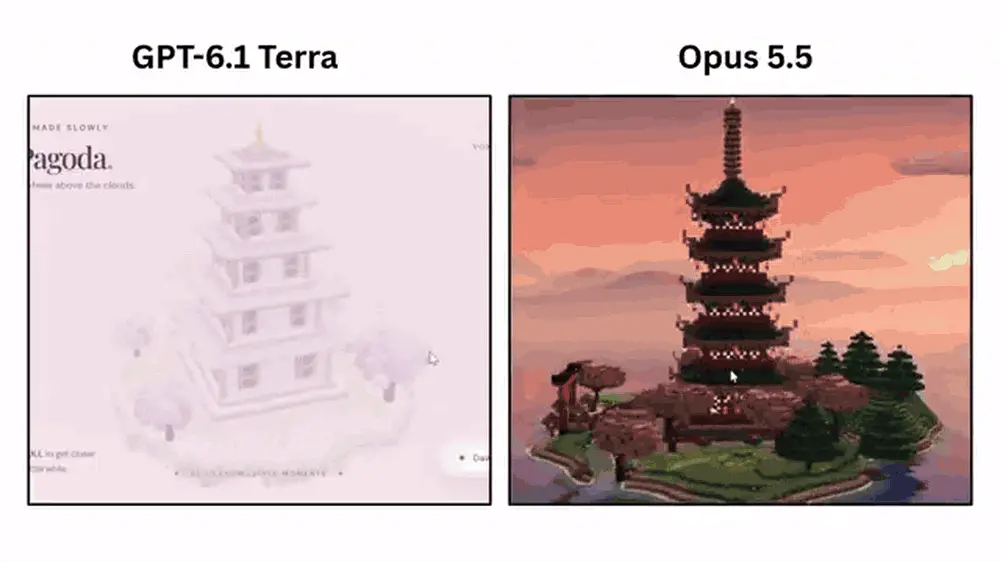
04 當中端模型開始算帳
Terra發布後,圍繞它的討論很快延伸到模型市場的競爭。
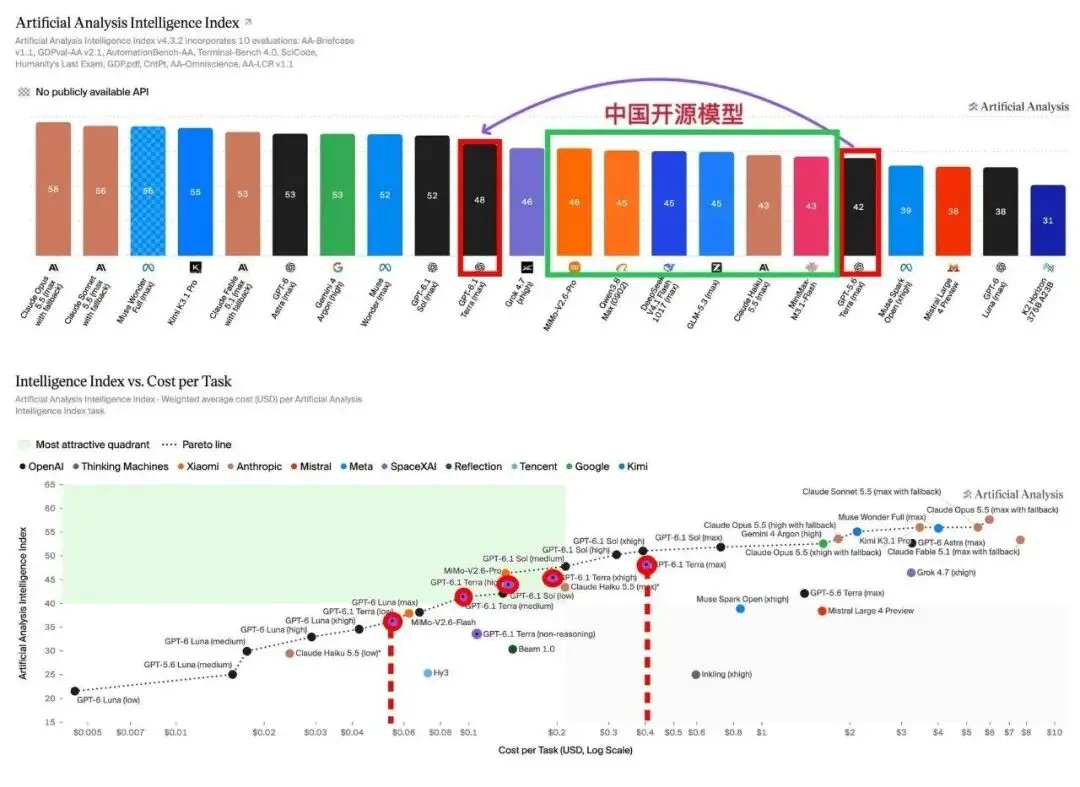
AI開發者@NFT_Chen援引Artificial Analysis的智能指數數據強調,GPT-6.1 Terra在最高推理強度下獲得48分,高於多款中國模型。
儘管這不直接等同於產品競爭力,但它反映出一個現實:模型之間的競爭已經延伸到不同推理強度下的成本、速度和任務完成質量。
@NFT_Chen認為,如果用戶需要深度判斷、複雜架構設計和高質量創作,可以優先考慮Claude Opus 5.5;如果工作以明確規格的開發、文檔和終端操作為主,Sonnet 5.5也具備競爭力;而Terra更適合高頻辦公、跨應用操作以及對成本敏感的自動化任務。
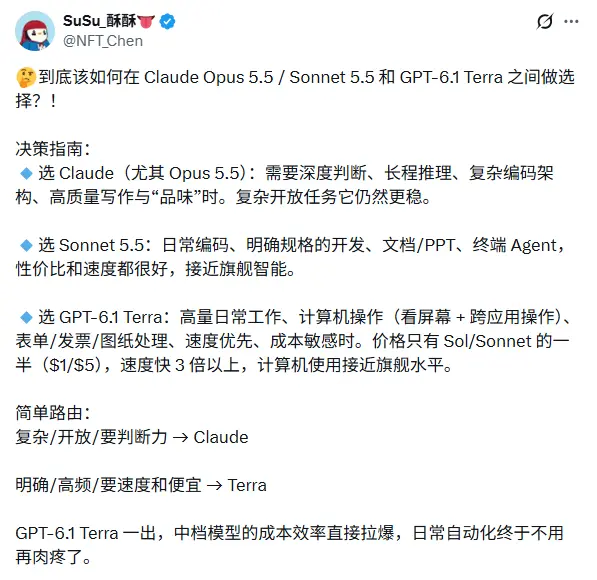
這種選擇方式也與OpenAI對Terra的定位一致。官方明確建議,深入研究和複雜編程仍優先考慮GPT-6.1 Sol或GPT-6 Astra。Terra則希望用更低的價格覆蓋大量日常工作。
目前,GPT-6.1 Terra已向ChatGPT Work和Codex中的Plus、Pro、Enterprise及Edu用戶開放,開發者也可以通過OpenAI API調用。標準價格為每百萬輸入Token 1美元、快取輸入Token 0.05美元、輸出Token 5美元。
對於需要大量調用模型的企業和開發者而言,價格下降可以直接影響自動化項目的成本。但如果某項任務對視覺質量、複雜推理或代碼可靠性要求很高,模型仍然需要經過實際測試,而不能只看單Token價格。